本文要点
这篇实操记录由大明按每天在后台真实盯店的顺序整理:一是打开邮件工作台先看 7 个独立站点的实时邮件计数标签、Gmail 已发送双向同步状态,以及按 8 类客户意图自动隔离推销信;二是点开真实查件工单(#94494)对照核实买家原文中文直译、L1 单号匹配决策链与中英双语草稿;三是打开 v4.0 独立配置中心在线微调 System Prompt 与勾选开关 45 条品牌 SOP;四是切到「AI运行」总控台管理本机 Qwen、Gemini、DeepSeek 与 GPT 五条模型车道,按六大业务场景自动执行 FAST/DEEP 分流、SHA-256 幂等缓存与跨厂降级。
下文保留本次升级的六张控制台脱敏截图与配置台账;涉及 Gmail 线程接口、Shopify GraphQL 与多模型缓存机制的通用规范,可查阅文末官方文档。
实操记录整理日期:2026 年 10 月 29 日
大家好,我是大明。
前两天把客服邮件台的三栏视图和 4PX 运费对账跑通之后,我没有急着催客服同事立刻放弃 Gmail 切到新后台,而是先按我自己的习惯做了一段“双轨磨合”:让同事们继续在熟悉的 Gmail 里正常回信,我在 Simbatch 后台挂了一个实时同步任务,每分钟去跟 Gmail 的「已发送」和「收件箱」做双向对齐。这样做有两个好处:一是系统能把真人客服每天实际写出来的回复话术、改地址核对流程和查单习惯默默学进知识库;二是我自己可以每天在后台点开真实工单,一步步把多站点标签、AI 审稿界面、SOP 热开关和底层的多模型路由器调顺。
在这段实操打磨的过程里,我主要给自己解决了四个每天都会碰到的麻烦:手头的独立站增加到 7 个之后,我怎么打开页面第一眼就看清每个站今天积压了多少封信,并且随时把新店铺接进来?我点开一封信审稿时,怎么在两三秒内确认 AI 草稿里的单号和轨迹是真查出来的、而不是瞎编的?当我想改某条售后话术或者停掉某条过时的 SOP 时,能不能在页面上自己点一下开关就生效,不用每次都喊程序员改代码发版?还有最核心的一点——当 7 个站的邮件直译、双语草稿、买家破损图识别和商品主图精修同时在后台跑的时候,我怎么把这些任务分给最合适的模型车道,既省成本又不会因为某家接口突然限流而卡住?
今天这几块功能刚好全部按我的操作习惯跑顺了。我刚在自己的控制台里截了六张真实界面(涉及具体独立站域名、买家姓名和完整运单号的地方我都打了码),把我自己每天在后台怎么看、怎么点、怎么调的过程记下来分享给大家。
七个站点放进同一屏:我每天打开收件箱先看网站标签计数与八类意图分流
以前多个独立站的客服邮箱汇总到一起之后,我最头疼的就是打开列表分不清轻重缓急。哪个主力站今天爆单后催件信激增、哪个新站只有零星几封问询、哪些信其实只是海外机构的 SEO 外链推销,全混在一个长列表里。
所以我在邮件工作台顶部给自己加了两个每天必看的筛选栏(见图 1 与图 2)。Google Workspace Gmail API 线程与标签同步指南
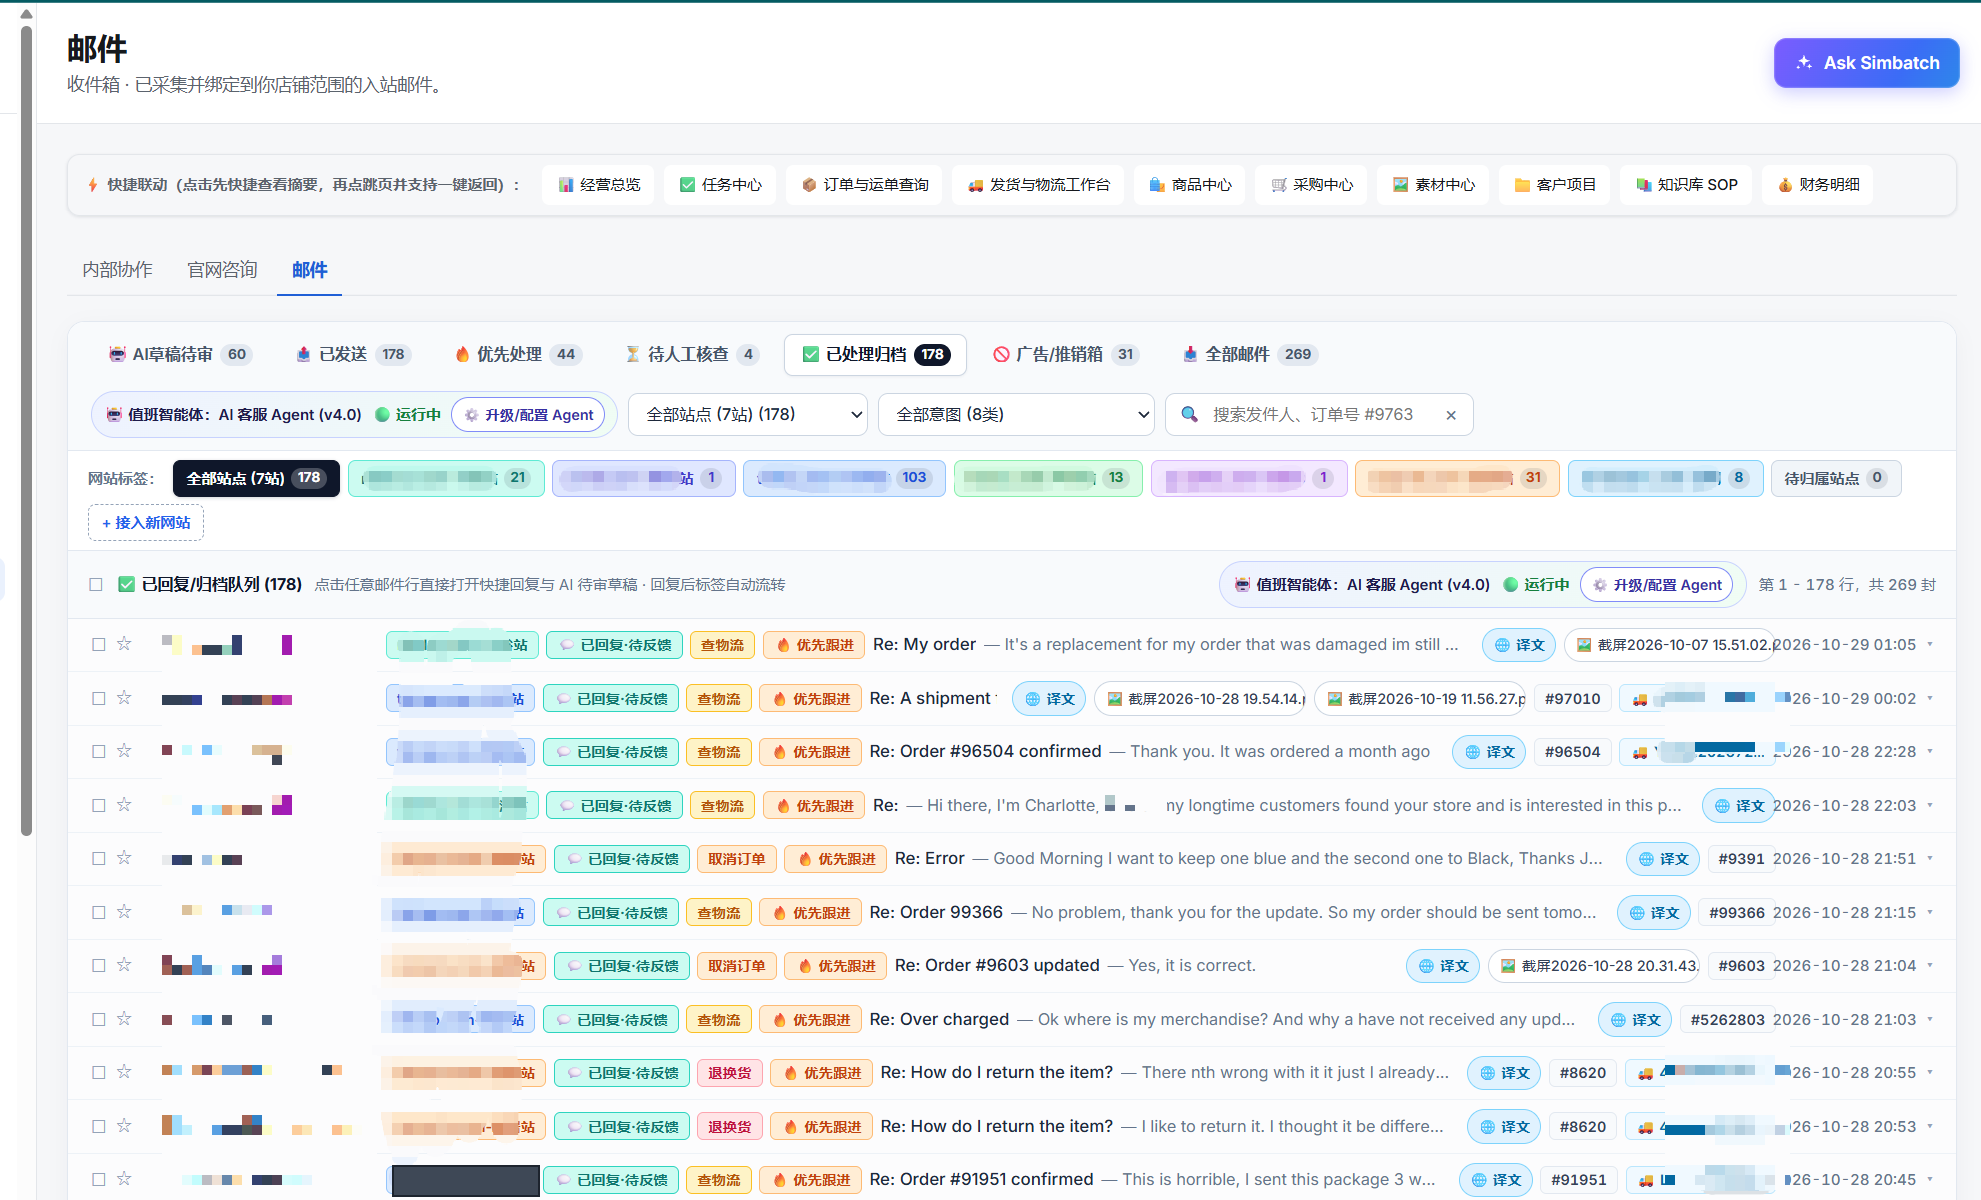
我现在每天打开图 1 这个页面,视线第一眼先扫中间那排彩色的「网站标签」。除了黑色的 全部站点 (7站) 178 之外,后面跟着的七个独立站标签上都实时跳动着当前队列的邮件数——比如排在中间的主力站有 103 封,旁边的站点分别是 31 封、21 封、13 封、8 封和 1 封,最右边的 待归属站点 是 0。我想集中巡检哪个站点,直接点一下对应的彩色胶囊就行;如果下周我们新开第 8 个店,我也不用找开发改配置,自己点一下左下角的 + 接入新网站,把新站域名、客服邮箱和 Shopify 只读查单权限填进去,新站点的标签和计数马上就会出现在这一排。
列表里的状态标签我也让它跟 Gmail 做了实时联动。只要客服同事在 Gmail 网页端回过信,Simbatch 抓到同一线程下的出站记录,就会自动把这行标成绿色的 已回复·待反馈 并归进已处理队列;万一买家过了两天又顺着原邮件追问了一句,系统识别到最新一封信来自买家,就会立刻挂上橙色的 🔥 优先跟进 重新顶回待办列表,我巡检的时候一眼就能逮住二次追问的工单。
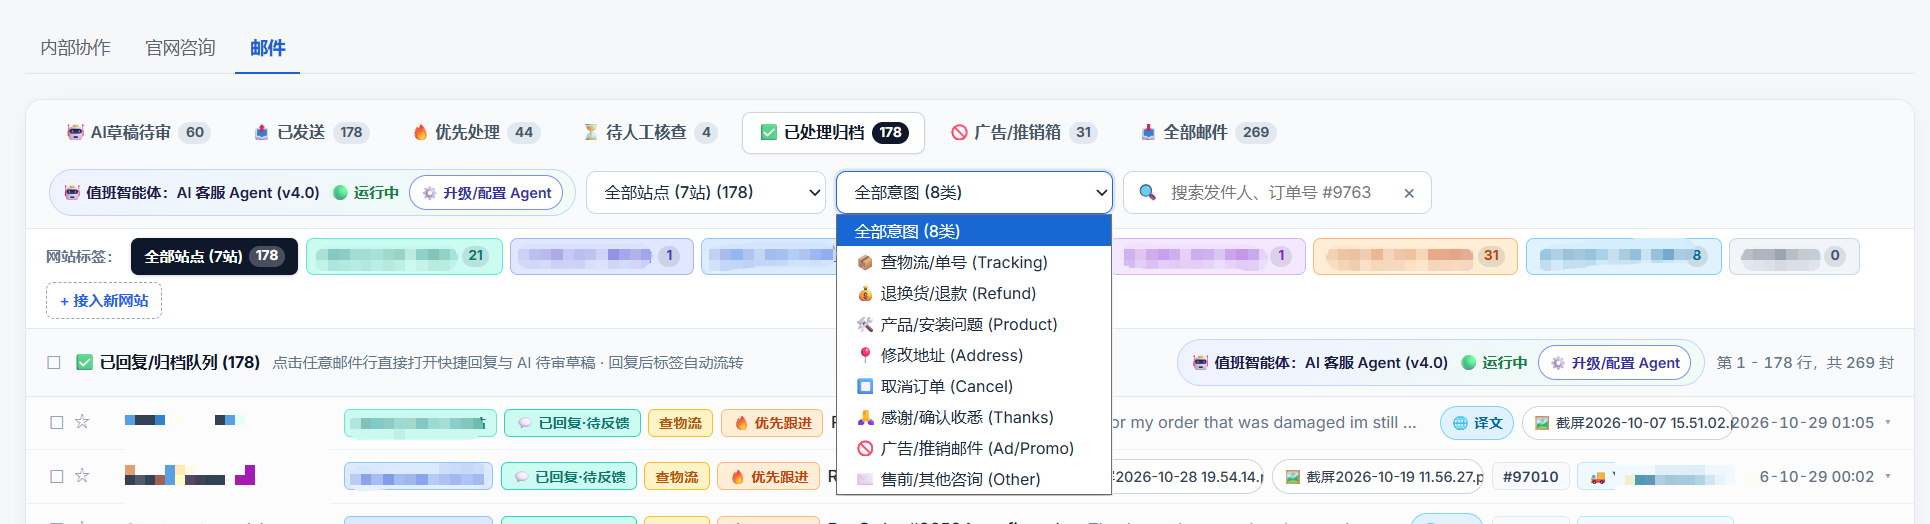
为了把同类问题攒在一起高效处理,我让系统在邮件进站落库的那一刻,自动按八类客户意图做好归类(见图 2 下拉菜单):查物流/单号 (Tracking)、退换货/退款 (Refund)、产品/安装问题 (Product)、修改地址 (Address)、取消订单 (Cancel)、感谢/确认收悉 (Thanks)、广告/推销邮件 (Ad/Promo) 和 售前/其他咨询 (Other)。像平时最烦人的海外营销机构推销信、红人建联广告(图 1 顶部可以看到一共拦下了 31 封),进站时直接被扔进独立的 广告/推销箱,再也不会混在正常买家的催件信里干扰我审稿。
我平时怎么审一封查件信:左边看原文与中文直译,右边核对决策链与双语草稿
以前为什么我自己也不太放心直接发 AI 写出来的客服草稿?因为很多工具只给你吐出一段漂亮的英文,你根本不知道它里面写的发货状态是真从数据库查出来的,还是模型顺嘴胡编的,为了核实还得自己再去后台搜一遍单号。
所以在改这版审稿界面时,我定了一个死规矩:点开任何一封邮件,必须把“查单证据”、“推理过程”和“双语草稿”同时摊在左右两栏里让我一眼看清(见图 3)。Shopify Admin GraphQL API 订单与履约查询规范
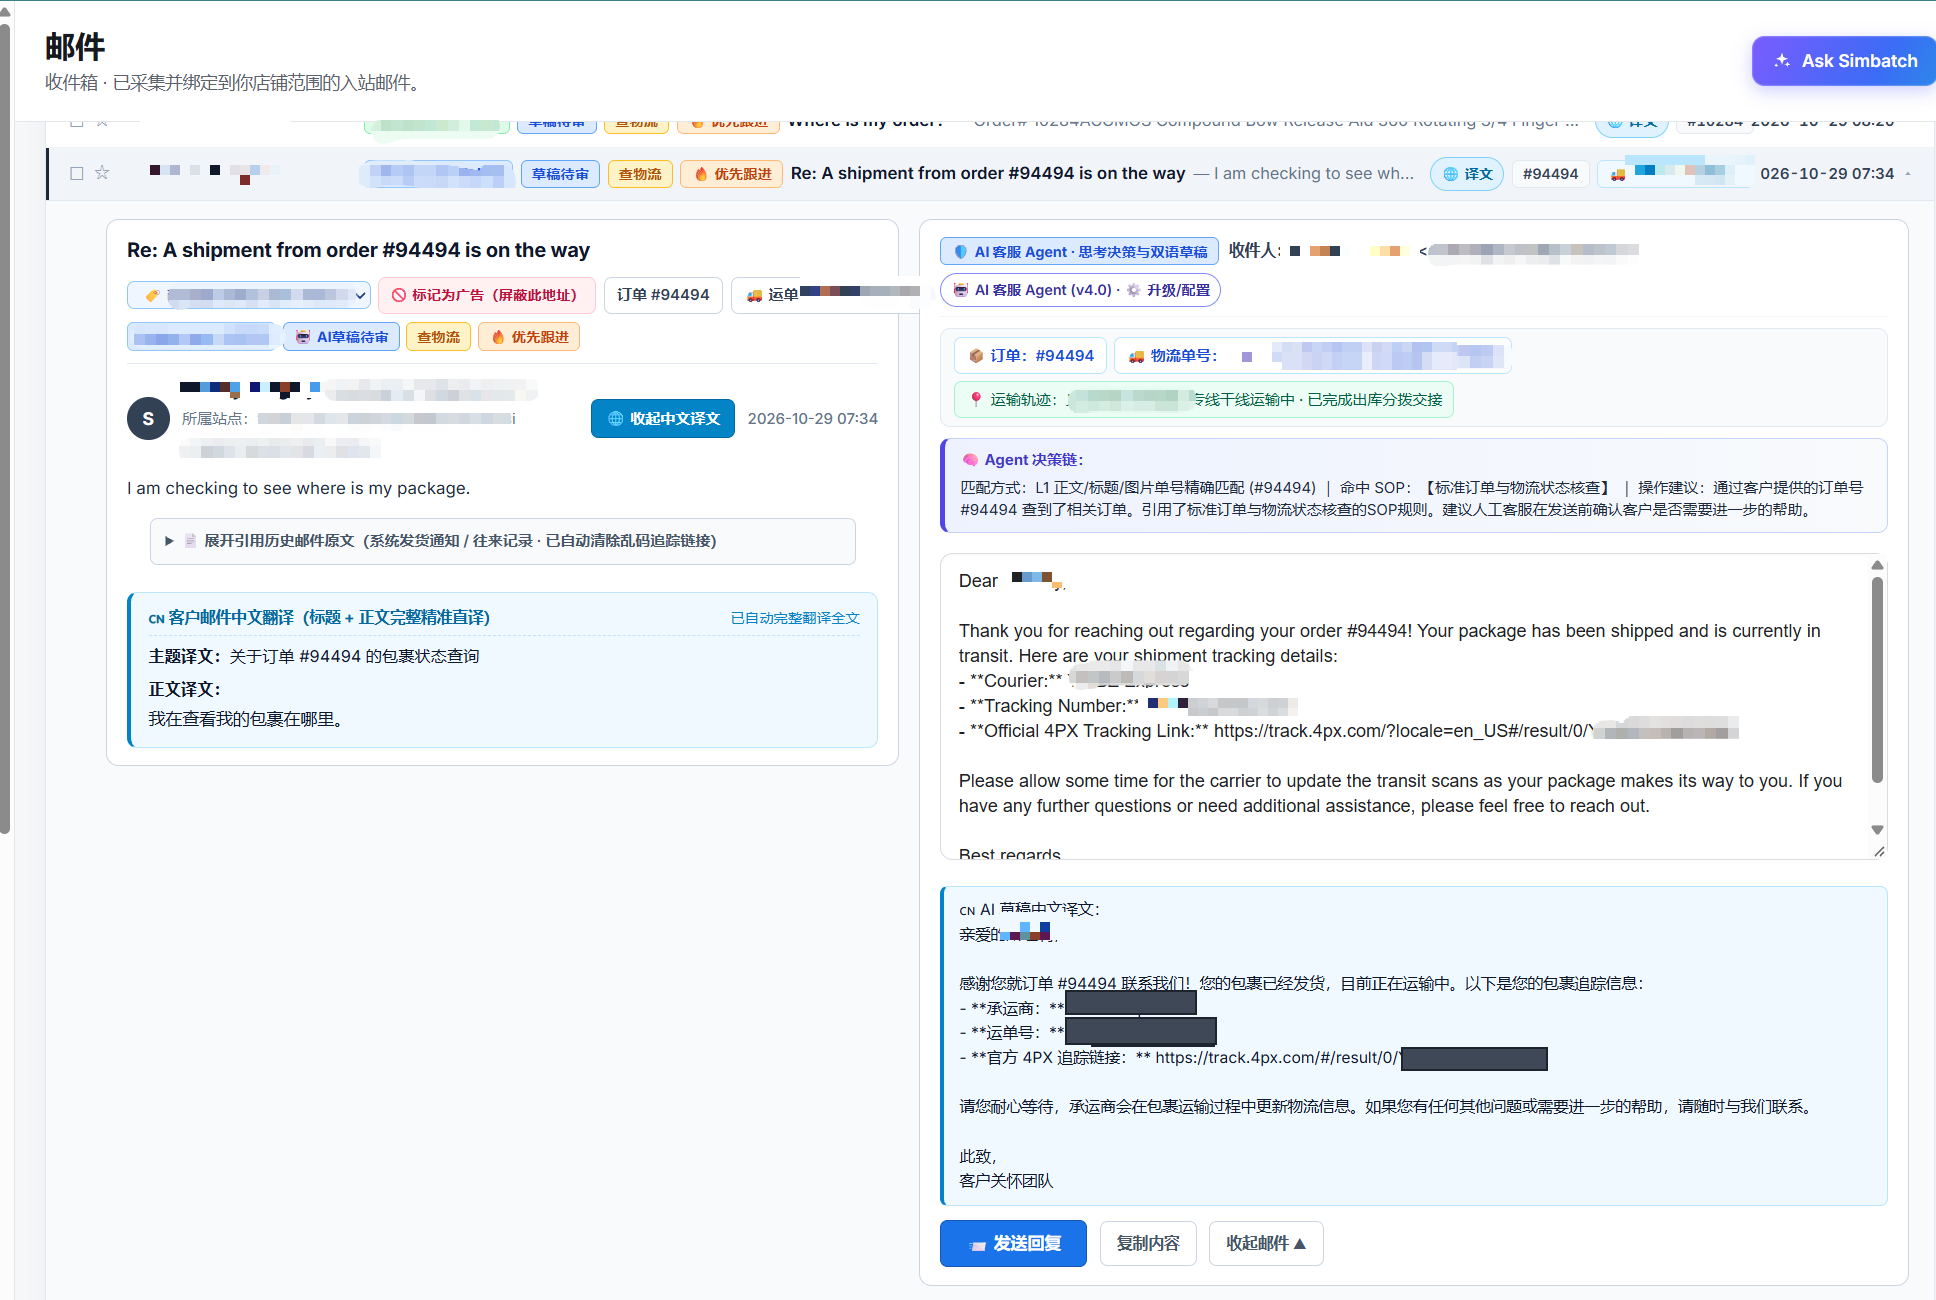
拿我刚点开的这封 #94494 真实查件工单来说,买家发来的正文就一句话:“I am checking to see where is my package.”。我点开这行邮件之后,视线是这么走完整个审稿动作的:
我先看左边这一栏。最上面保留着干干净净的买家原文,以前邮件底下拖着的那几十行发货通知历史引用和 17track 乱码追踪链接,已经被系统自动清洗并折叠进「展开引用历史邮件原文」里了;再往下看左栏底部的浅蓝色卡片,标题和正文的完整中文直译已经提前生成好了(主题译文:关于订单 #94494 的包裹状态查询;正文译文:我在查看我的包裹在哪里),哪怕是英文不太熟的客服同事,也不用再去复制粘贴到翻译软件里。
接着我把目光移到右栏的「AI 客服 Agent · 思考决策与双语草稿」。我第一眼先核对最顶上那排胶囊:系统已经通过四级查单引擎自动对上了 📦 订单: #94494,抓出了真实的 🚚 物流单号 以及绿色的实时物流状态 📍 运输轨迹: 专线干线运输中 · 已完成出库分拨交接。看到这三个胶囊挂在上面,我心里就有底了——说明这封信是真查到单了。
紧接着看中间那张紫底的 🧠 Agent 决策链 卡片,它用大白话告诉我这封草稿是怎么写出来的:匹配方式: L1 正文/标题/图片单号精确匹配 (#94494) | 命中 SOP: 【标准订单与物流状态核查】 | 操作建议: 通过客户提供的订单号 #94494 查到了相关订单。引用了标准订单与物流状态核查的SOP规则。建议人工客服在发送前确认客户是否需要进一步的帮助。
最后我扫一眼右栏下方的上下两个文本框。上面是准备发给买家的英文回复草稿(里面已经自动填好了订单号 #94494、承运商、真实运单号和官方 4PX 追踪链接 https://track.4px.com/...),下面紧跟着逐句对齐的「CN AI 草稿中文译文」。我对照着中文译文确认语气和单号都没问题,直接点最底下的蓝色「发送回复」按钮,从点开邮件到审完发走,前后也就三四秒钟。
想改话术不用喊程序员:我怎么在 v4.0 配置中心里直接调 Prompt 和开关 45 条 SOP
在日常盯店的时候,售后口径经常需要根据实际情况微调。比如某款车载支架最近常被问到“吸盘在皮质仪表台上粘不住怎么办”,或者某批订单因为仓库盘点需要向客户解释“24 到 48 小时出库预留期是为了方便核对改地址或改型号”。要是每改一句话都要提需求让程序员改代码、重新部署服务器,那我自己在业务一线就太被动了。
所以我干脆把 AI 客服 Agent (simbatch_cs_agent · v4.0) 拎出来做成了一个随时能打开的独立配置弹窗。我在邮件台顶上点一下「升级/配置 Agent」按钮,就能直接进到图 4 这个控制面板。
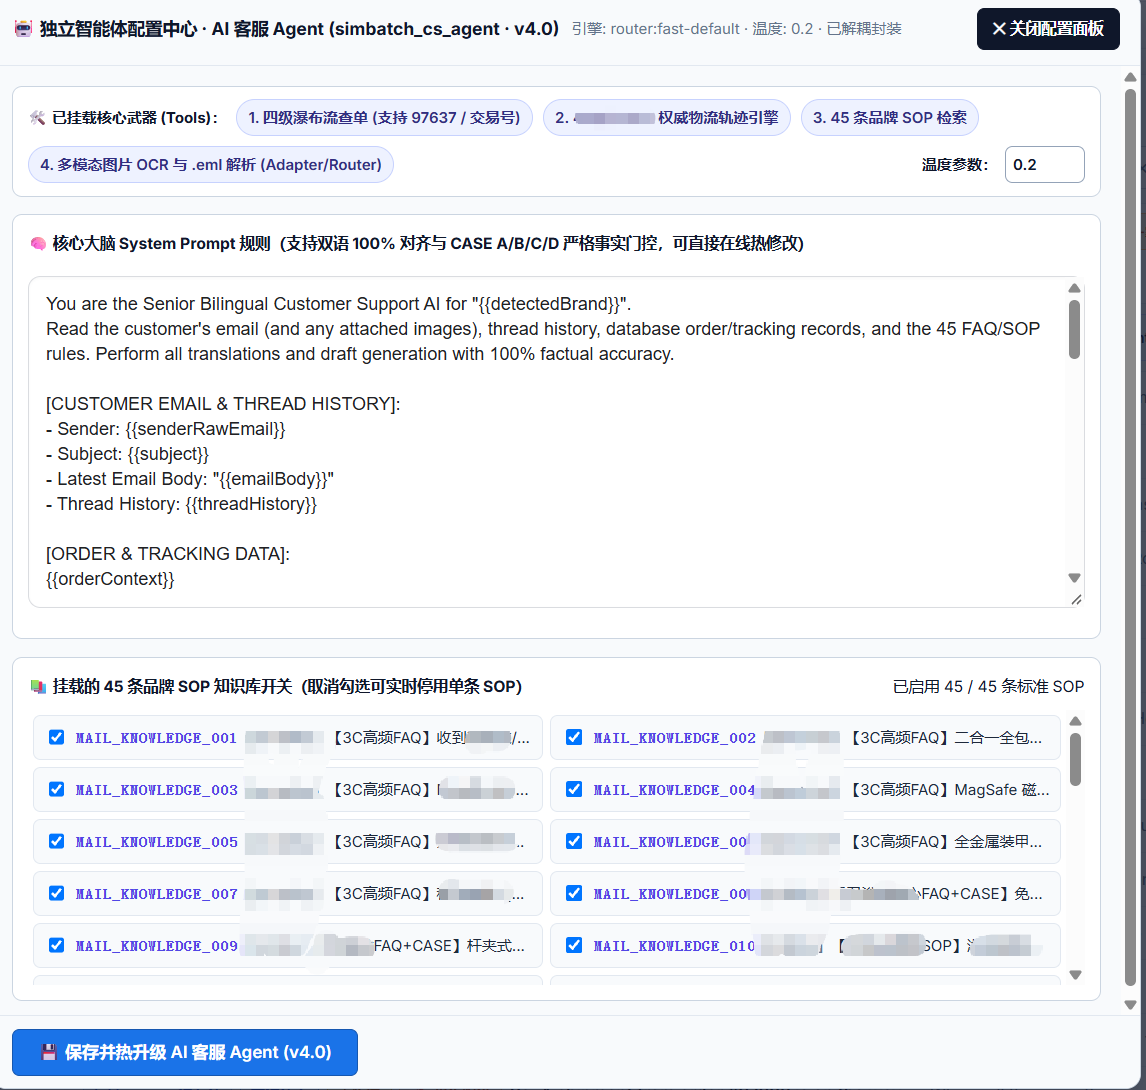
打开图 4 这个配置中心,最顶上一排先列出了我给这个 Agent 挂载的四件查证工具:第一件是支持按订单号、邮箱和 PayPal 交易号层层深挖的「四级瀑布流查单」;第二件是「权威物流轨迹引擎」;第三件是「45 条品牌 SOP 检索」;第四件是通过 Adapter/Router 接入的「多模态图片 OCR 与 .eml 原始邮件解析」——平时买家拍过来的包裹破损照片或者转发的扣款截图,这件工具会先自动识图把里面的单号和画面细节抽出来喂给 Agent。右边我还把生成温度死死锁在 0.2,不让模型在回复客户时自由发挥。
平时我自己动手改得最多的是下面这两块区域:
中间那个大文本框是可直接在线修改的核心 System Prompt 规则。我在这里面给 AI 立了严格的 CASE A/B/C/D 铁律——比如查到了真实运单号必须附上官方 4PX 链接;查到已付款但还没出库要怎么解释预留期;特别是当数据库里没查到单号时,绝对禁止模型自己编造“包裹已在路上”之类的假话,只能老老实实向买家索要订单号或付款截图。
最底下那排带蓝色勾选框的列表,就是从我们各个站点 FAQ 和 Gmail 真人客服优秀回复里沉淀出来的 45 条品牌 SOP 知识库开关(从 MAIL_KNOWLEDGE_001 一直排到 045)。平时只要某条旧规则不适用了,我甚至不用改提示词,直接把那条 SOP 前面的蓝勾点掉,再点一下左下角的「保存并热升级 AI 客服 Agent (v4.0)」,下一秒进来的新邮件就会立刻按更新后的规则生成草稿。
切到「AI运行」总控台:我怎么用 5 条模型车道与 FAST/DEEP 路由把速度和成本同时控住
当 7 个站点的邮件中文直译、双语客服草稿、买家附件识图、商品主图精修和自媒体文案全都跑在同一套系统里之后,我很快意识到一个问题:绝不能把所有请求都硬绑死在某一家大模型的单一接口上。一方面,查件翻译这种简单活儿如果全用最贵的重型推理模型,既慢又烧钱;另一方面,万一某家外部 API 突然抽风限流,前台客服审稿就会跟着转圈卡死。
按照我给 Simbatch 定的总纲底线,我们的业务系统绝不绑死任何单一模型厂商,所有外部大模型和本机模型一律通过可替换的 Adapter(适配器)与 Router(智能路由器) 接入。平时我想看各个模型的健康状态或者调整分流策略,就会切到后台左侧菜单的「AI运行」总控台(见图 5 与图 6)。OpenAI API 模型路由与缓存机制文档
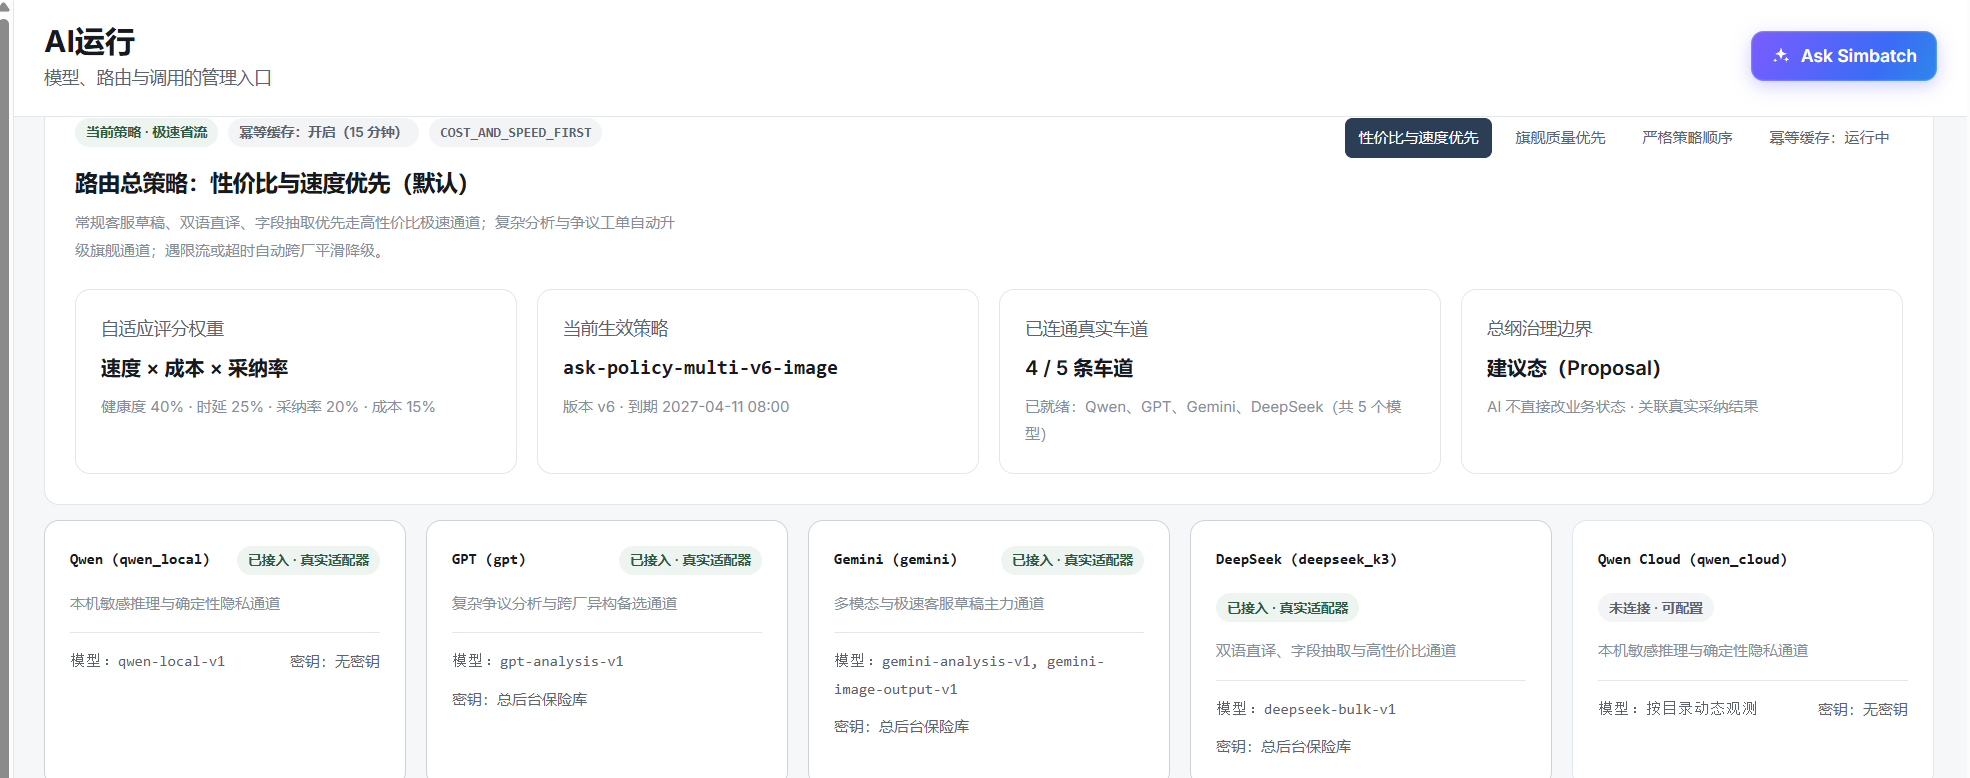
看图 5 顶部那四张状态卡片,就是我平时巡检 AI 底座最常看的地方。第一张卡片显示路由器正在按实时健康度、响应延迟和客服同事的历史采纳率做动态选路,哪个通道又快又稳就优先走哪个;第二张卡片显示当前挂的策略版本是 ask-policy-multi-v6-image,并且开启了 15 分钟同指纹幂等缓存,我如果觉得某段时间需要极致响应,可以在右上角的下拉框里随时把路由偏好切成「速度优先」或「旗舰质量优先」;第三张卡片显示当前有 4 / 5 条车道 处于绿灯就绪状态;第四张卡片则是我最看重的总纲红线——所有 AI 输出一律锁在 建议态 (Proposal),绝不允许任何模型绕过人工确认直接去改订单或发信。
往下一排看,就是我已经接进来的五条解耦适配器车道:最左边的 Qwen (qwen_local) 跑在我们自己的本地机器上(Qwen3.5-9B),专门干敏感数据脱敏和零外部成本的确定性推理;旁边的 GPT (gpt)、Gemini (gemini)、DeepSeek (deepseek_k3) 和备用的 Qwen Cloud (qwen_cloud) 各司其职——比如 Gemini 负责多模态图片识图和极速客服草稿,DeepSeek 负责跑量最大的邮件中文直译和字段抽取,GPT 则留着啃最复杂的退款争议分析和跨厂异构备选。所有接口密钥全部锁在总后台保险库里,前端页面和业务代码里看不到半个明文 Key。
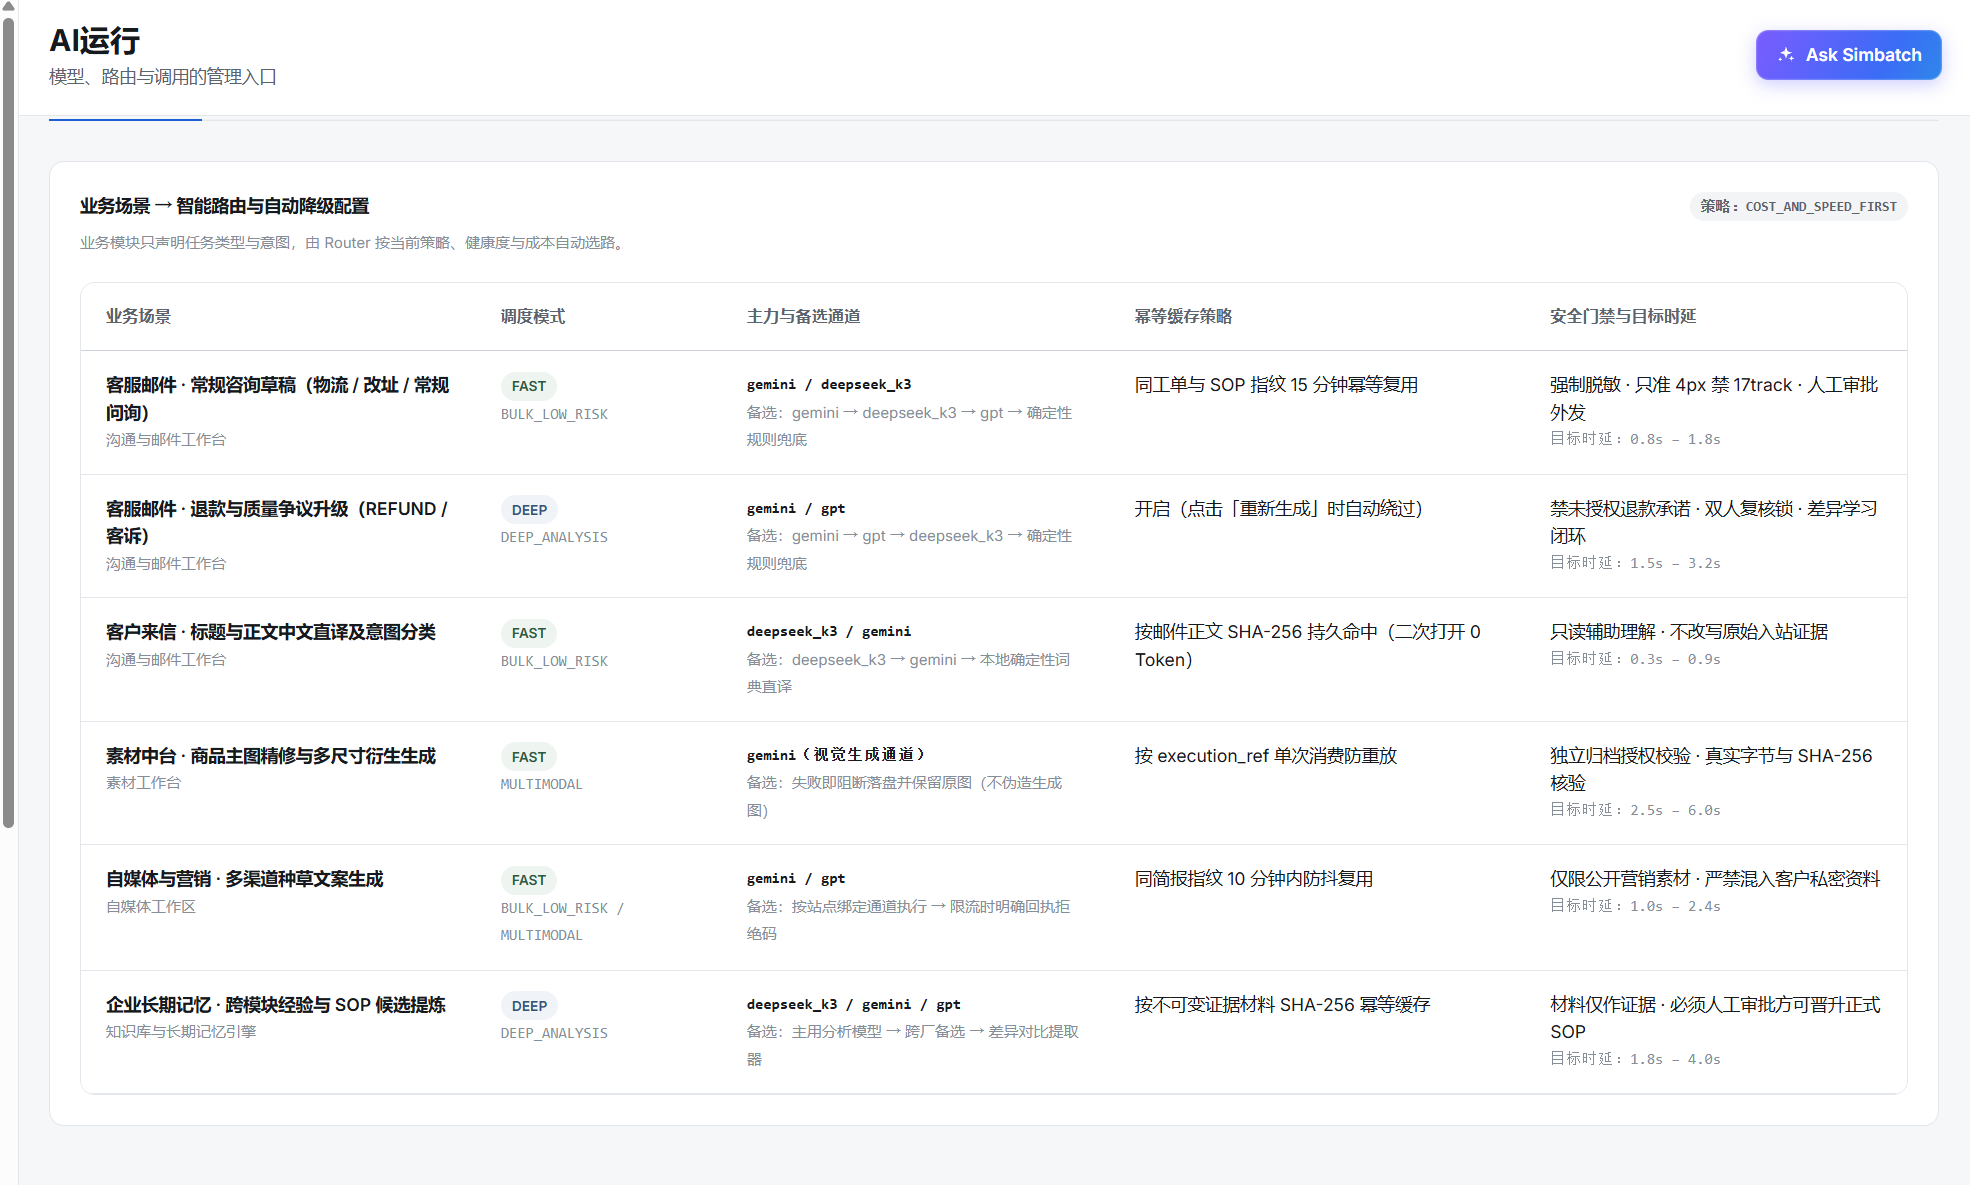
为了让各个模块调用时足够傻瓜化,我在图 6 这张「业务场景 → 智能路由与自动降级配置」表里把日常六大高频场景的分流规则定死了。Google Gemini API 上下文缓存与多模态指南
前端不管是邮件台、素材中台还是长期记忆模块,调 AI 时根本不用管底层接的是哪家厂商,只管报出自己的业务场景名,路由器就会自动按下面这张表做 FAST / DEEP 分流、SHA-256 缓存命中和跨厂降级:
| 业务场景 | 调度档位 | 主力与备选降级链 | 幂等缓存策略(极速防抖核心) | 安全门禁与目标时延 |
|---|---|---|---|---|
| 客服邮件 · 常规咨询草稿(物流/改址/常规问询) | FAST (BULK_LOW_RISK) | gemini / deepseek_k3(备选自动降级至 gpt → 确定性规则兜底) | 同工单与 SOP 指纹 15 分钟幂等复用 | 强制脱敏 · 只准官方 4PX 禁 17track · 人工审批外发(0.8s - 1.8s) |
| 客服邮件 · 退款与质量争议升级(REFUND/客诉) | DEEP (DEEP_ANALYSIS) | gemini / gpt(备选 deepseek_k3 → 确定性规则兜底) | 默认开启(点击「重新生成」时自动绕过) | 禁未授权退款承诺 · 双人复核锁 · 差异学习闭环(1.5s - 3.2s) |
| 客户来信 · 标题与正文中文直译及意图分类 | FAST (BULK_LOW_RISK) | deepseek_k3 / gemini(备选 本地确定性词典直译) | 按邮件正文 SHA-256 持久命中(二次打开直接命中缓存) | 只读辅助理解 · 不改写原始入站证据(0.3s - 0.9s) |
| 素材中台 · 商品主图精修与多尺寸衍生生成 | FAST (MULTIMODAL) | gemini(视觉生成通道) | 按 execution_ref 单次消费防重放 | 独立归档授权校验 · 真实字节与 SHA-256 核验(2.5s - 6.0s) |
| 自媒体与营销 · 多渠道种草文案生成 | FAST (BULK_LOW_RISK / MULTIMODAL) | gemini / gpt | 同简报指纹 10 分钟内防抖复用 | 仅限公开营销素材 · 严禁混入客户私密资料(1.0s - 2.4s) |
| 企业长期记忆 · 跨模块经验与 SOP 候选提炼 | DEEP (DEEP_ANALYSIS) | deepseek_k3 / gemini / gpt | 按不可变证据材料 SHA-256 幂等缓存 | 材料仅作证据 · 必须人工审批方可晋升正式 SOP(1.8s - 4.0s) |
自从把这六条场景路由跑通之后,我自己平时点后台最直观的感受就是“既快又不花冤枉钱”:一封海外买家的英文信刚进站,先走 FAST 通道在零点几秒内完成中文直译和八类意图归类,并且按邮件正文的 SHA-256 指纹持久存进数据库——后面不管是我自己巡检点开、还是客服同事点开,全都是毫秒级直接读缓存,一分钱重复的 Token 都不花;占日常八成以上的查物流、改地址问询走 FAST 通道一秒出头就能生成双语草稿,同时由安全门禁死死卡住“只准给官方 4PX 追踪链接、绝不准出现 17track 乱码链接”;一旦碰到买家要求退款或者投诉质量问题,路由器会自动把这单升档到 DEEP 深度推理通道并挂上双人复核锁。哪怕某一家云端模型突然遇到限流,路由器也会顺着备选链无缝切到下一条模型车道甚至本地确定性规则兜底,我们在前台审稿完全感觉不到任何卡顿。
常见问题(FAQ)
客服团队还在用 Gmail 回信过渡时,Simbatch 怎么保证两边状态不打架?
我在后台挂了定时同步任务,同时扫描 Gmail 的收件箱与已发送(in:sent)线程。只要客服同事已经在 Gmail 里回复了某位买家,Simbatch 抓到该线程下的最新出站邮件后,会自动把工单状态更新为 已回复·待反馈 并归档,同时把真人回复里用到的运单号和标准话术提取出来沉淀到知识库;一旦买家顺着邮件再次追问,系统会自动挂上 优先跟进 标签重新顶回待办列表。
为什么要在多模型路由器里把业务任务拆成 FAST 和 DEEP 两种调度模式?
因为不同任务对响应速度和推理深度的要求完全不一样。我们 7 个独立站日常收到的邮件里,八成以上是查物流单号、核对收货地址或常规尺码问询,这类问题事实很清楚,走 FAST 极速通道在 1 秒左右就能结合数据库运单号与站点 SOP 生成标准双语草稿;而遇到退款争议、产品质量客诉或者跨模块长期记忆提炼时,需要结合多轮历史往来与图片证据做严谨分析,由路由器自动升档到 DEEP 通道并配合双人复核锁,既保证了日常工单的秒级审稿,又守住了复杂客诉的处理质量。
我在「独立智能体配置中心」里勾选停用某条 SOP,需要重启服务器或找程序员发版吗?
完全不需要。我们在设计 AI 客服 Agent (v4.0) 时,已经把工具挂载、温度参数、System Prompt 模板和 45 条品牌 SOP 开关从代码里彻底剥离出来,保存在后台配置表中。我平时在页面上取消勾选某条过时的 SOP 或者微调几句提示词后,点一下「保存并热升级」,下一秒进来的邮件生成草稿时就会实时按最新启用的规则执行。
如果某一家大模型的 API 突然限流或者出现故障,客服工作台会卡死报错吗?
不会。因为 Simbatch 底层没有把业务逻辑绑死在任何单一模型厂商的 SDK 上,而是通过统一的 Adapter 和 Router 接入了本机 Qwen、Gemini、DeepSeek 和 GPT 等多条车道。当主力通道遇到限流或超时,路由器会自动顺着备选链跨厂平滑降级,极端情况下还会启用本地确定性规则模板兜底,确保我们在前台审稿和发信不中断。
官方参考资料
本文记录 Simbatch 团队的内部系统工程实践。涉及外部平台接口、权限范围与结构化数据标准,请结合下列官方文档核对(整理日期:2026 年 10 月 29 日):
相关阅读
- 美区 Shopify Payments 开通实录:这次很顺利,把操作过程分享给你
查看美区独立站收款开通与打款账户核对过程。
- 香港主体 Shopify Payments 开通实录:六张截图看懂验证、收款与自动打款
查看香港主体的验证资料、收款状态与自动打款记录。
- Shopify Capital、Sidekick与Payments分别能做什么?
区分独立站支付收款、融资与 AI 运营辅助工具的适用边界。
- Google Merchant Center 是什么?主要用途与真实截图注册教程
结合真实后台截图查看 Google Merchant Center 注册与商品展示配置。
如需了解 Simbatch 跨境业务操作系统与多模块联动架构,可查看 Simbatch 系统,或通过 官网联系页面与我们交流。